Fiabilidad de la plataforma
Confiabilidad de la plataforma: diseñada para seguir funcionando cuando una parte falla
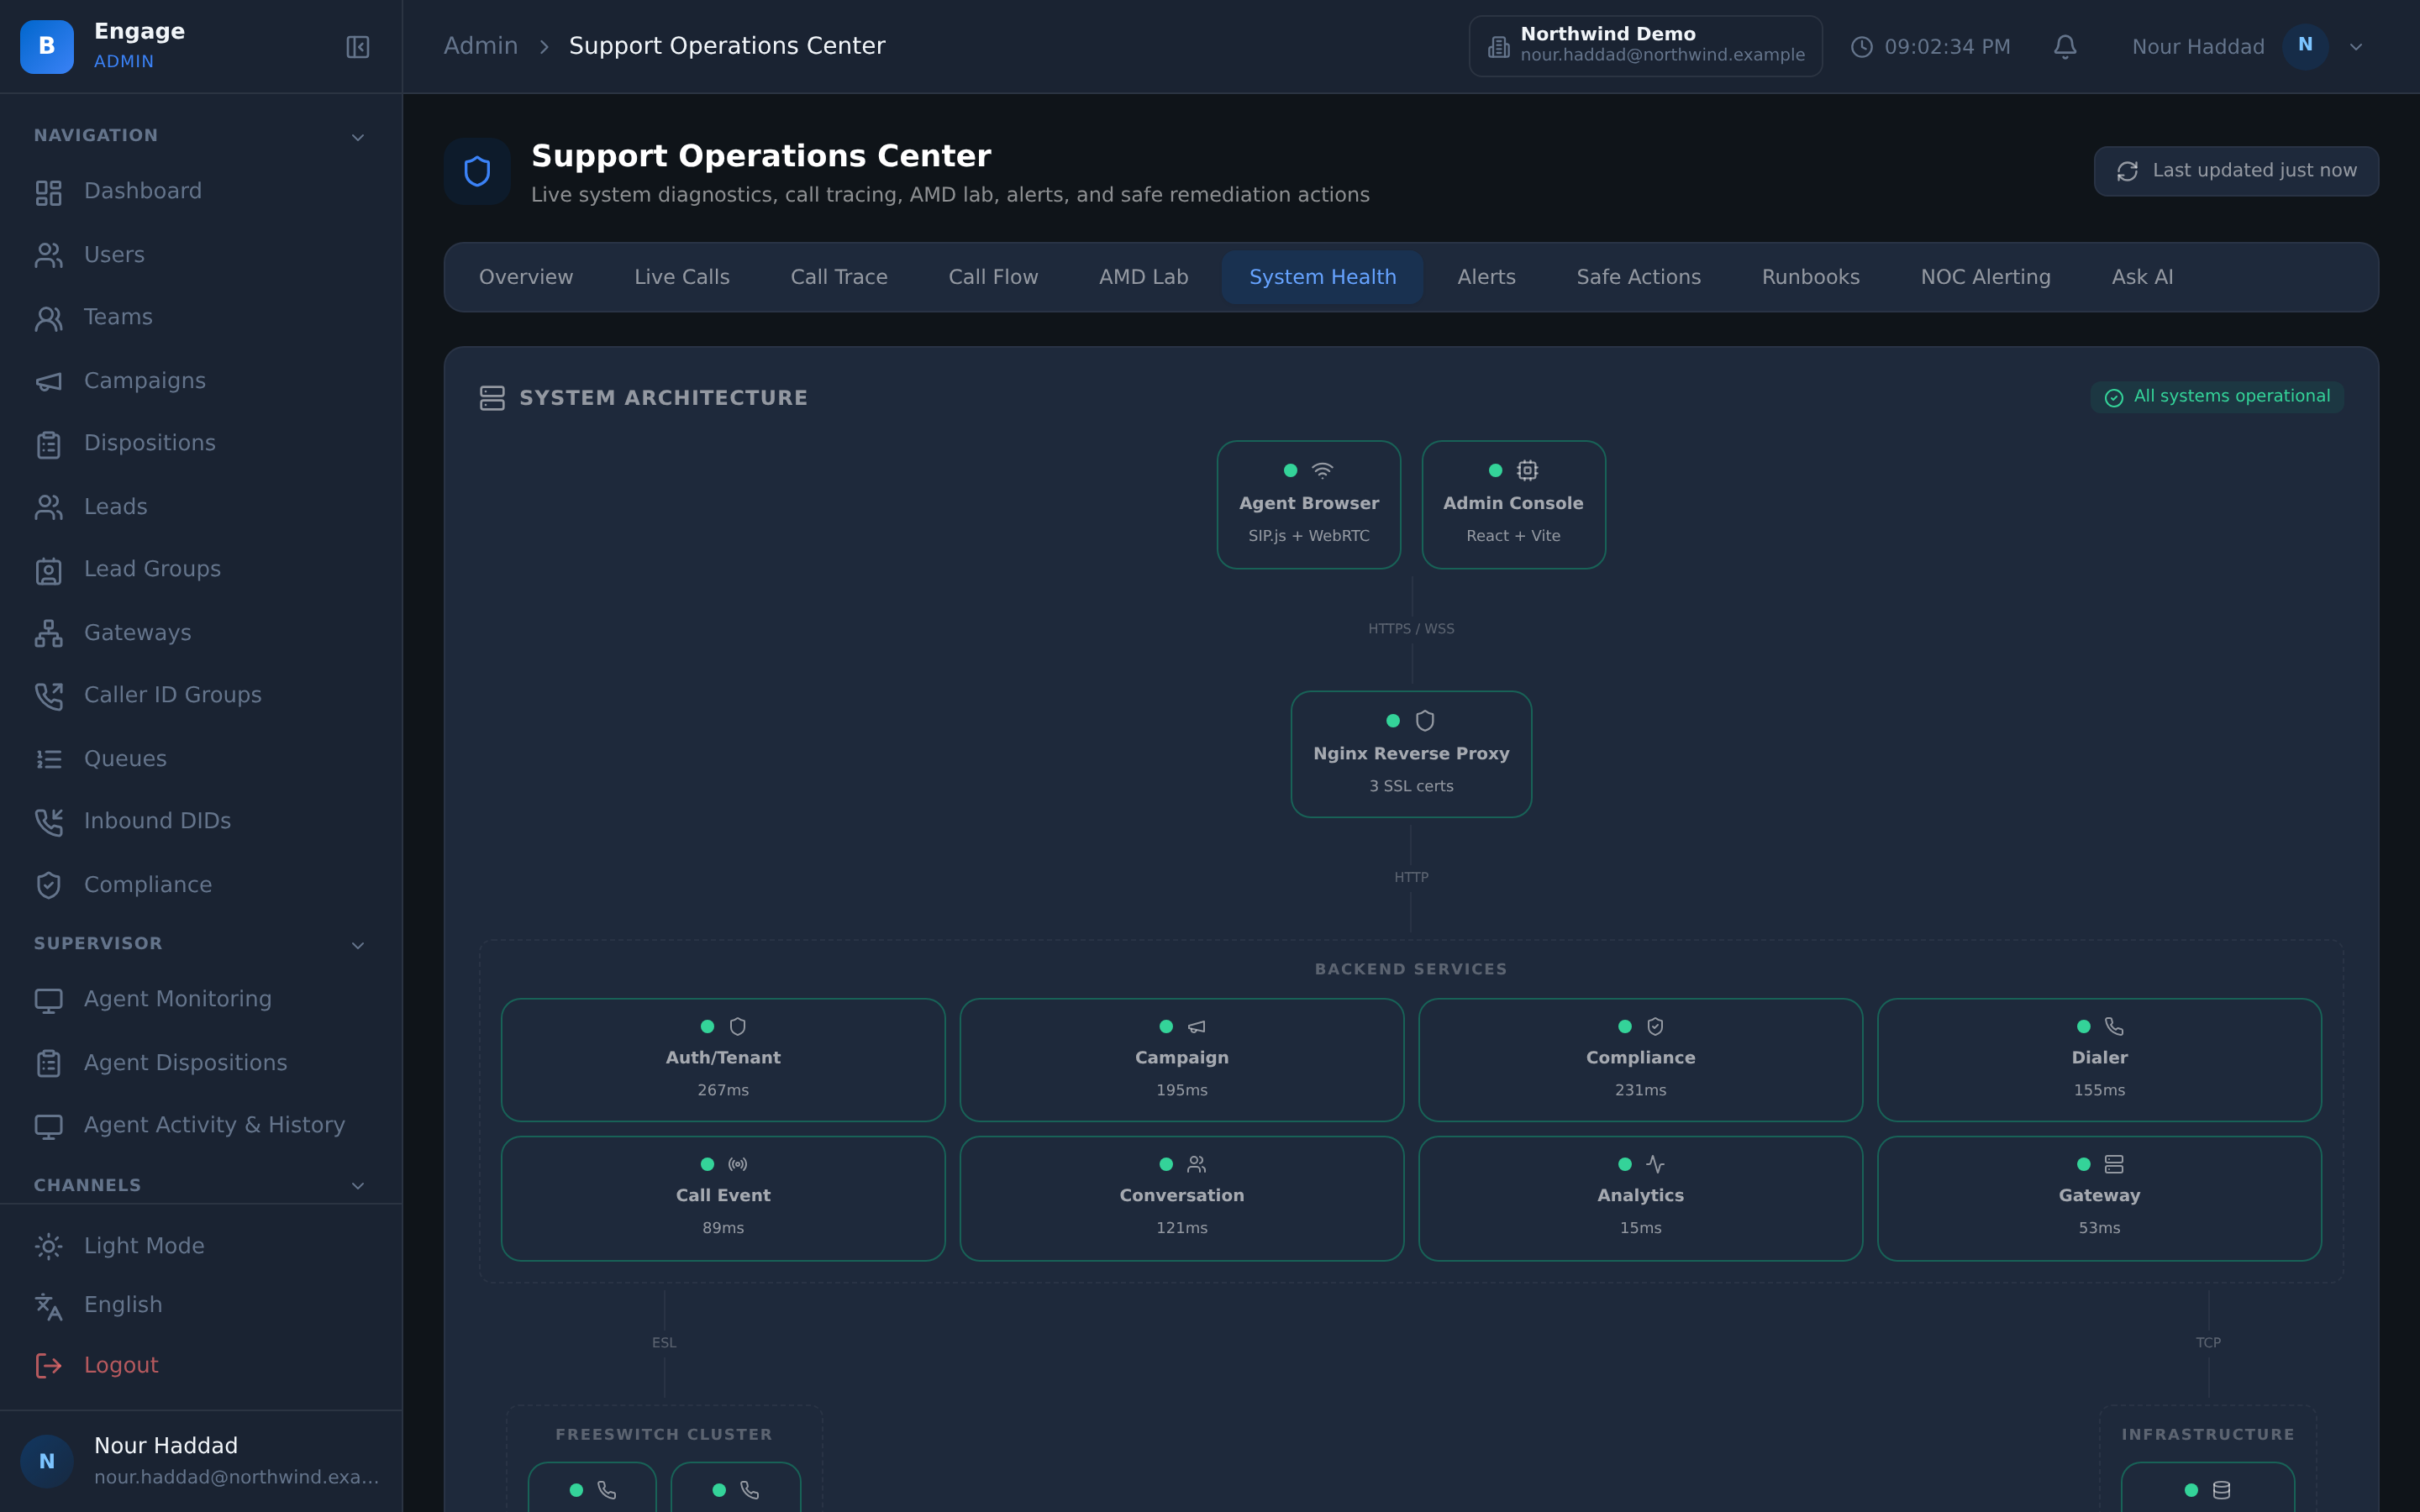
Dos nodos de medios FreeSWITCH con failover de agentes al reconectar, WebRTC con balanceo de carga, un balanceador de carga SIP que reparte las llamadas entre los nodos, comprobaciones de disponibilidad que revisan las dependencias reales, reconciliadores que corrigen el estado tras una incidencia y copias de seguridad nocturnas fuera del sitio.
Prueba gratuita de 14 días · crédito de IA gratuito para probar el agente de voz con IA · sin tarjeta
Respuesta rápida
Lo que obtiene
Todo en un solo espacio de trabajo
Dos nodos de medios FreeSWITCH
Los medios funcionan en dos nodos FreeSWITCH en lugar de uno. Con un solo nodo, una sola tarde basta para que toda su operación se caiga.
Failover de WebSocket de agentes
El escritorio del agente mantiene un WebSocket con un nodo de medios. Si ese nodo deja de estar disponible, el cliente del agente conmuta al otro al reconectarse.
WebRTC con balanceo de carga
El audio de los agentes en el navegador se reparte con balanceo de carga entre los nodos, para que los agentes queden distribuidos en lugar de amontonarse en el nodo que respondió primero.
SIP en rotación (round-robin)
Un balanceador de carga SIP distribuye las llamadas por rotación entre los nodos de medios, para que el tráfico del operador no dependa de que un solo nodo siga activo.
Disponibilidad que tiene en cuenta las dependencias
Los endpoints de disponibilidad comprueban las dependencias que un servicio realmente necesita antes de declararlo listo. A un servicio que no puede llegar a su base de datos no se le debería enviar tráfico.
Reconciliador de llamadas huérfanas
Las llamadas que perdieron su registro de control se reconcilian en lugar de seguir activas. Una llamada huérfana genera costes, ocupa un canal y no ayuda a nadie.
Reconciliador de agentes bloqueados
Un agente atascado en un estado del que no puede salir se detecta y se devuelve a un estado real, en lugar de pasar el turno como un fantasma.
Reconciliador de llamadas en curso
Las llamadas en curso durante un reinicio o una incidencia se reconcilian después con la realidad, para que la visión de la plataforma y la de la central coincidan.
Copias de seguridad nocturnas de la base de datos
La base de datos se respalda cada noche. No a petición ni cuando alguien se acuerda, sino según un calendario.
Copias de seguridad fuera del sitio
Las copias de seguridad se guardan fuera del sitio, porque una copia que corre la misma suerte que aquello que protege no es una copia de seguridad.
SLA de disponibilidad en Enterprise
El plan Enterprise incluye un SLA de disponibilidad del 99.95%, recogido en el contrato y no simplemente insinuado en una página de marketing.
Visible desde el centro de operaciones
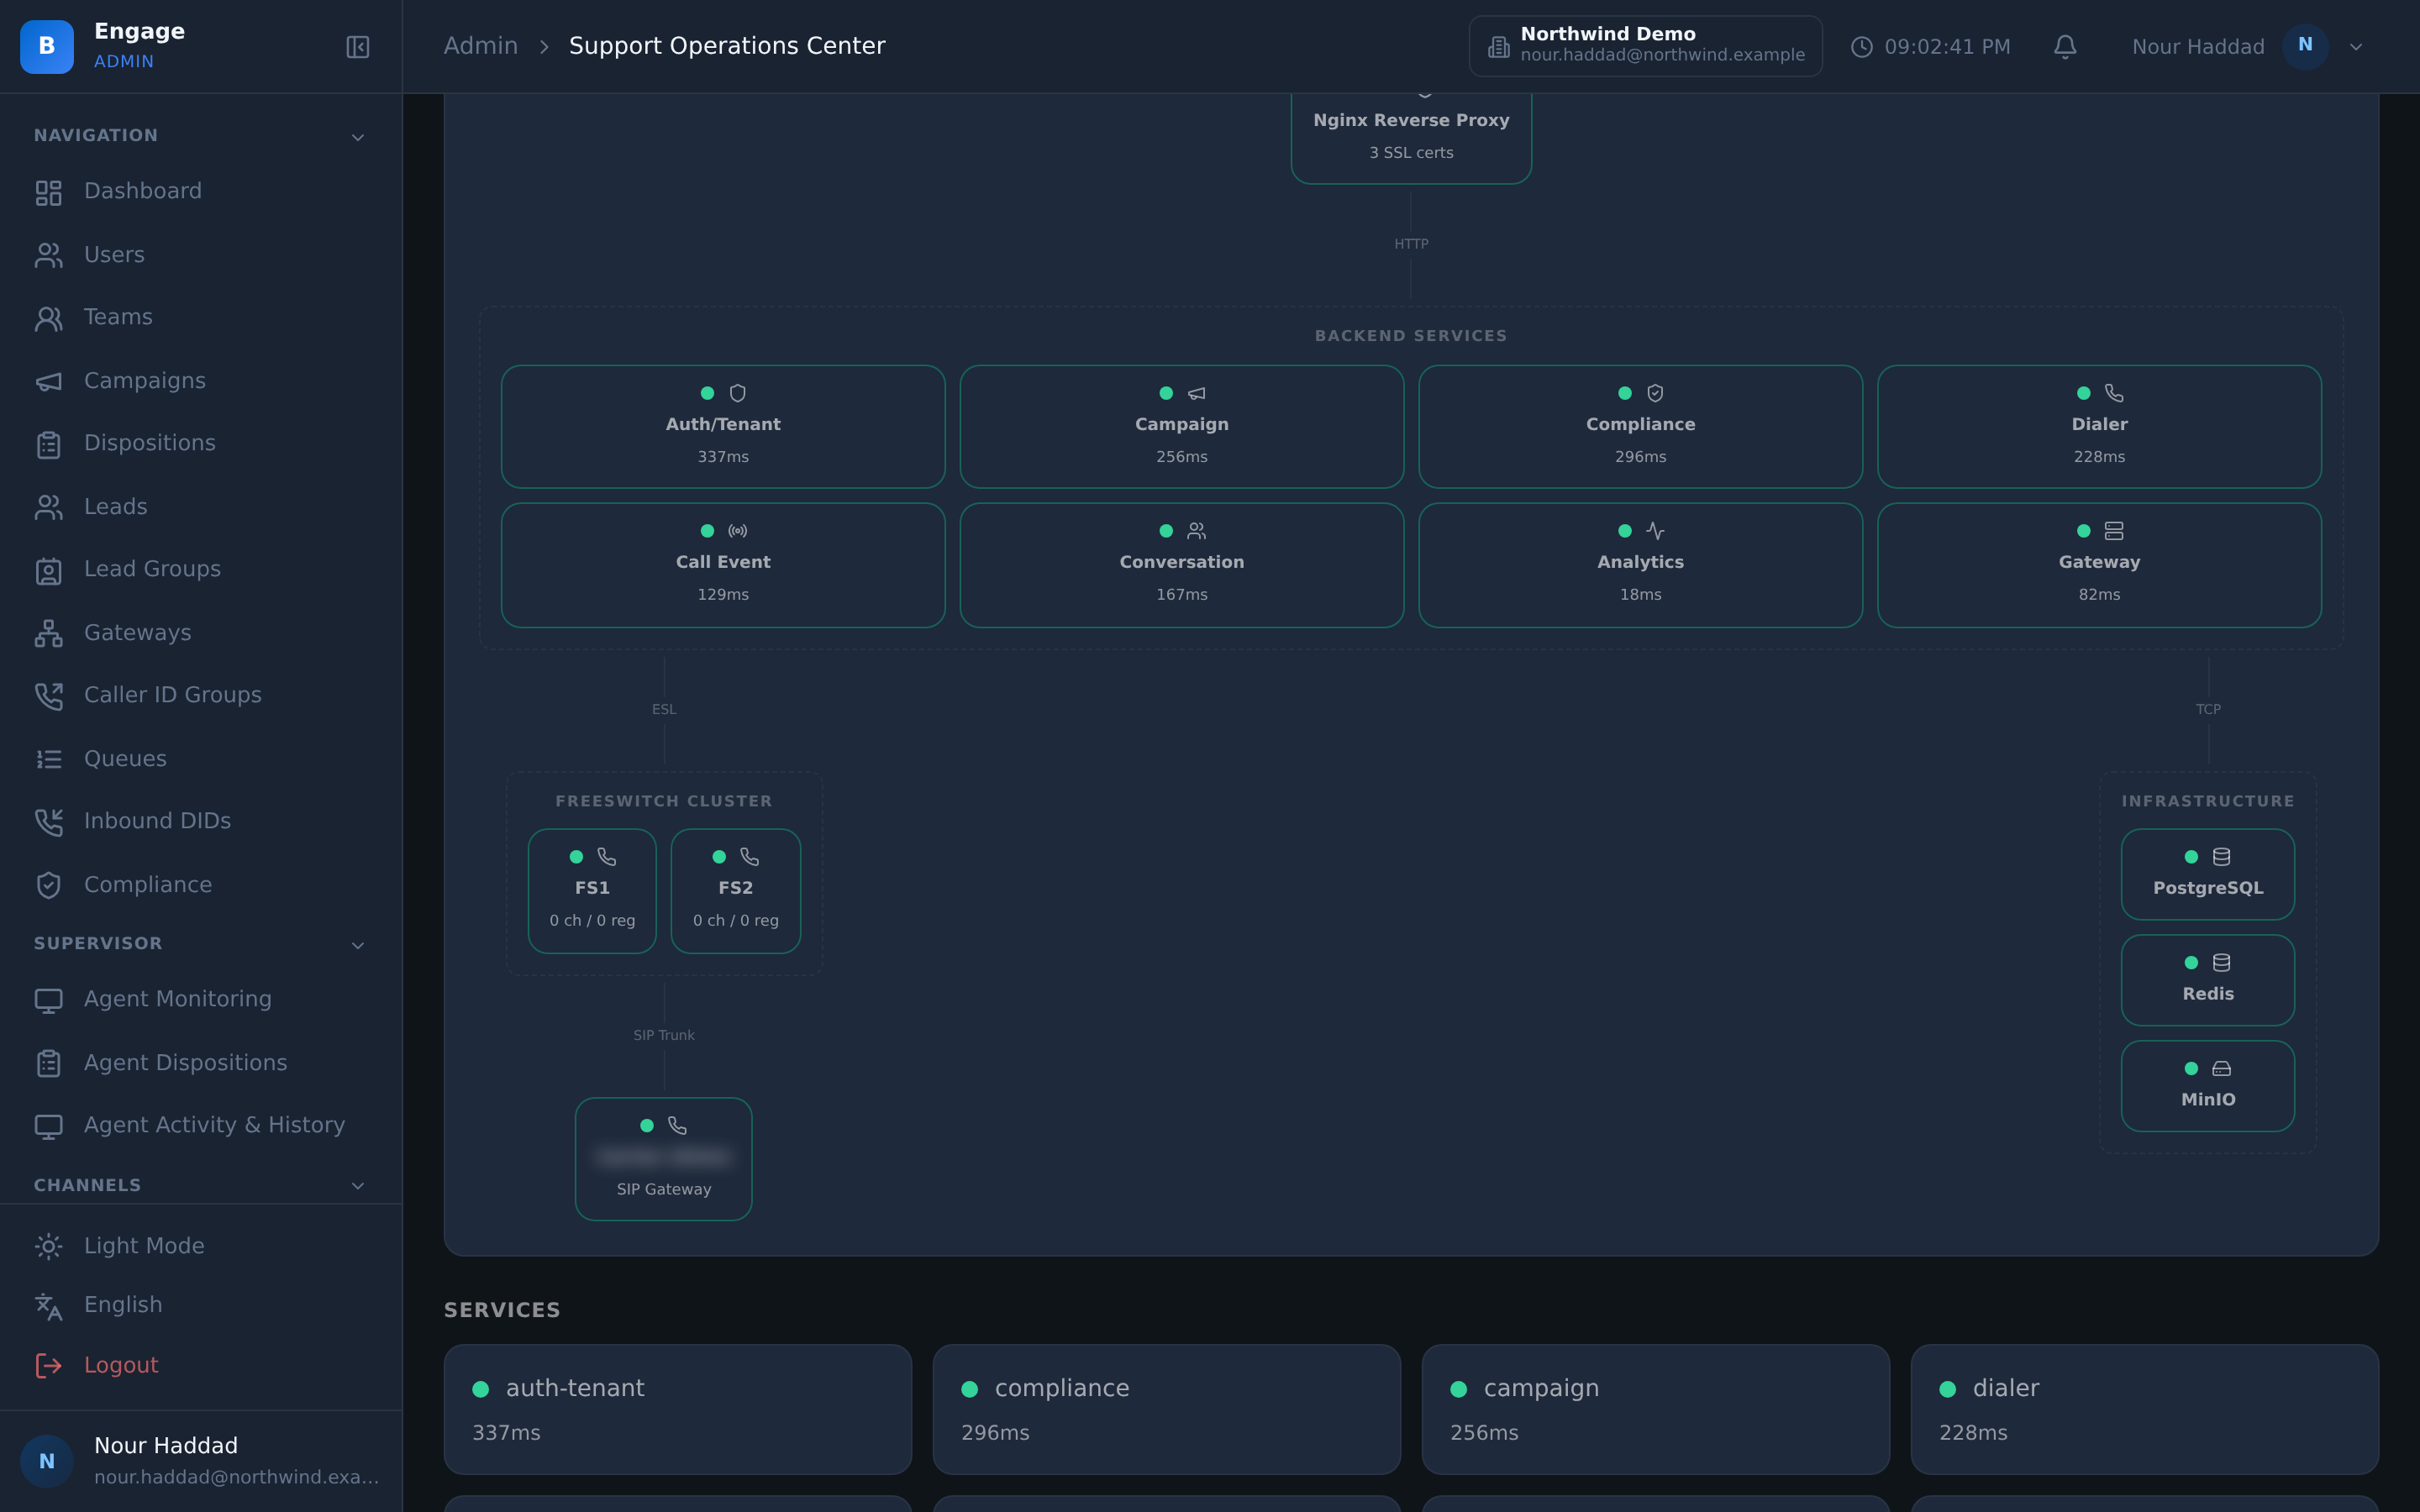
El estado de los nodos, las llamadas en vivo y la actividad de los reconciliadores son visibles en el centro de operaciones, así que la fiabilidad es algo que puede observar en lugar de darla por supuesta.
Media
Dos nodos, y un cliente que lo sabe
Los medios funcionan en dos nodos FreeSWITCH. Eso por sí solo es bastante habitual. Lo que decide si un agente nota una caída es lo que hace su navegador al respecto.
El escritorio del agente mantiene un WebSocket con un nodo y, cuando ese nodo deja de estar disponible, el cliente pasa al otro nodo al reconectar. WebRTC se reparte con balanceo de carga entre los nodos, y un balanceador de carga SIP envía el tráfico de los operadores en round-robin entre ellos, de modo que ni los agentes ni los operadores quedan atados a una sola máquina.
- Dos nodos de medios FreeSWITCH que transportan los medios
- Failover de WebSocket de agentes entre nodos al reconectar
- WebRTC con balanceo de carga para agentes en el navegador
- Balanceador de carga SIP que distribuye las llamadas en round-robin entre los nodos
Autocorrección
La plataforma se ordena a sí misma
Las plataformas de contact center no suelen fallar de forma estrepitosa. Fallan dejando cosas atrás: una llamada que sigue activa sin nada que la controle, un agente atascado en un estado del que no puede salir, una llamada que estaba en curso cuando se reinició un servicio.
Hay reconciliadores para los tres casos. Comparan lo que la plataforma cree con lo que realmente ocurre y corrigen la diferencia. Junto a ellos, los endpoints de disponibilidad comprueban las dependencias reales de un servicio antes de que se declare listo, para que a nada se le envíe tráfico que no puede atender.
- Reconciliador de llamadas huérfanas
- Reconciliador de agentes bloqueados
- Reconciliador de llamadas en curso durante reinicios
- Endpoints de disponibilidad que comprueban las dependencias antes de declarar el servicio listo
Copias de seguridad y compromiso
Cada noche, fuera del sitio y por escrito
La base de datos se respalda cada noche y las copias se guardan fuera del sitio. Ambas mitades importan. Una copia nocturna en la misma infraestructura que la plataforma es una copia, no un plan de recuperación.
Además, el plan Enterprise incluye un SLA de disponibilidad del 99.95%. Está en el contrato, que es donde debe estar un compromiso de disponibilidad, y no en una diapositiva.
- Copias de seguridad nocturnas de la base de datos
- Copias de seguridad guardadas fuera del sitio
- SLA de disponibilidad del 99.95% en el plan Enterprise
- Estado de los nodos, llamadas en vivo y actividad de los reconciliadores visibles en el centro de operaciones
Cómo se compara
| Una implementación en un solo servidor | Fiabilidad de la plataforma DialerBee | |
|---|---|---|
| Media | Un solo nodo | Dos nodos de medios FreeSWITCH |
| Cuando cae un nodo | Los agentes recargan y cruzan los dedos | Failover de WebSocket de agentes entre nodos al reconectar |
| Tráfico de los operadores | Dirigido a una sola dirección | Balanceador de carga SIP, en round-robin entre los nodos |
| Audio de los agentes | El nodo que respondió primero | WebRTC con balanceo de carga entre los nodos |
| Comprobaciones de estado | ¿Está vivo el proceso? | Endpoints de disponibilidad que comprueban las dependencias del servicio |
| Restos tras una incidencia | Alguien los encuentra más tarde | Reconciliadores de llamadas huérfanas, agentes bloqueados y llamadas en curso |
| Copias de seguridad | Cuando alguien se acuerda | Copias de seguridad nocturnas de la base de datos, guardadas fuera del sitio |
| Compromiso | Mejor esfuerzo | SLA de disponibilidad del 99.95% en el plan Enterprise |
Preguntas frecuentes
¿Qué es la fiabilidad de la plataforma en DialerBee?+
Es la forma en que la plataforma se mantiene en funcionamiento y se corrige a sí misma cuando algo falla. Los medios funcionan en dos nodos de medios FreeSWITCH con failover de WebSocket de agentes entre ellos al reconectar, WebRTC con balanceo de carga y un balanceador de carga SIP que distribuye las llamadas en round-robin entre los nodos. Los endpoints de disponibilidad comprueban las dependencias, los reconciliadores corrigen llamadas huérfanas, agentes bloqueados y llamadas en curso, y la base de datos se respalda cada noche y se guarda fuera del sitio.
¿Qué les pasa a mis agentes si falla un nodo de medios?+
El escritorio del agente mantiene un WebSocket con un nodo de medios. Si ese nodo deja de estar disponible, el cliente del agente pasa al otro nodo al reconectar, de modo que el agente vuelve a trabajar en el nodo que sigue activo en lugar de esperar al que falló.
¿Cómo se reparte el tráfico de llamadas entre los nodos?+
Un balanceador de carga SIP distribuye las llamadas en round-robin entre los nodos de medios, y el audio de los agentes en el navegador se reparte con balanceo de carga mediante WebRTC. Ni los operadores ni los agentes están atados a un solo nodo.
¿Para qué sirven los reconciliadores?+
Corrigen el estado que queda atrás cuando algo sale mal. Uno reconcilia las llamadas huérfanas, llamadas que siguen activas sin nada que las controle. Otro reconcilia los agentes bloqueados, agentes que quedaron en un estado del que no pueden salir. Otro reconcilia las llamadas que estaban en curso durante un reinicio. Cada uno compara lo que la plataforma cree con lo que realmente ocurre.
¿Qué significa una disponibilidad que tiene en cuenta las dependencias?+
Un endpoint de disponibilidad comprueba las dependencias que un servicio realmente necesita antes de informar de que está listo. A un servicio que no puede llegar a aquello de lo que depende no se le envía tráfico, y esa es la diferencia entre una comprobación de estado y una comprobación de estado útil.
¿Cómo se gestionan las copias de seguridad?+
La base de datos se respalda cada noche y las copias se guardan fuera del sitio. Lo de fuera del sitio es lo importante, porque una copia almacenada junto a la plataforma corre la misma suerte que la plataforma.
¿Hay un SLA de disponibilidad?+
Sí, un SLA de disponibilidad del 99.95% en el plan Enterprise. Está en el contrato y no en una página de marketing.
¿Puedo ver algo de esto por mí mismo?+
Sí. El centro de operaciones muestra el estado de los nodos, las llamadas en vivo y la actividad de los reconciliadores, junto con alertas que puede configurar para un NOC. Una fiabilidad que se puede observar es más útil que una fiabilidad que solo se promete.
Pregúntenos cómo se comporta DialerBee cuando cae un nodo
Un recorrido de 30 minutos en un tenant de demostración, en inglés o en árabe.