Affidabilità della piattaforma
Affidabilità della piattaforma: pensata per continuare anche se una parte si ferma
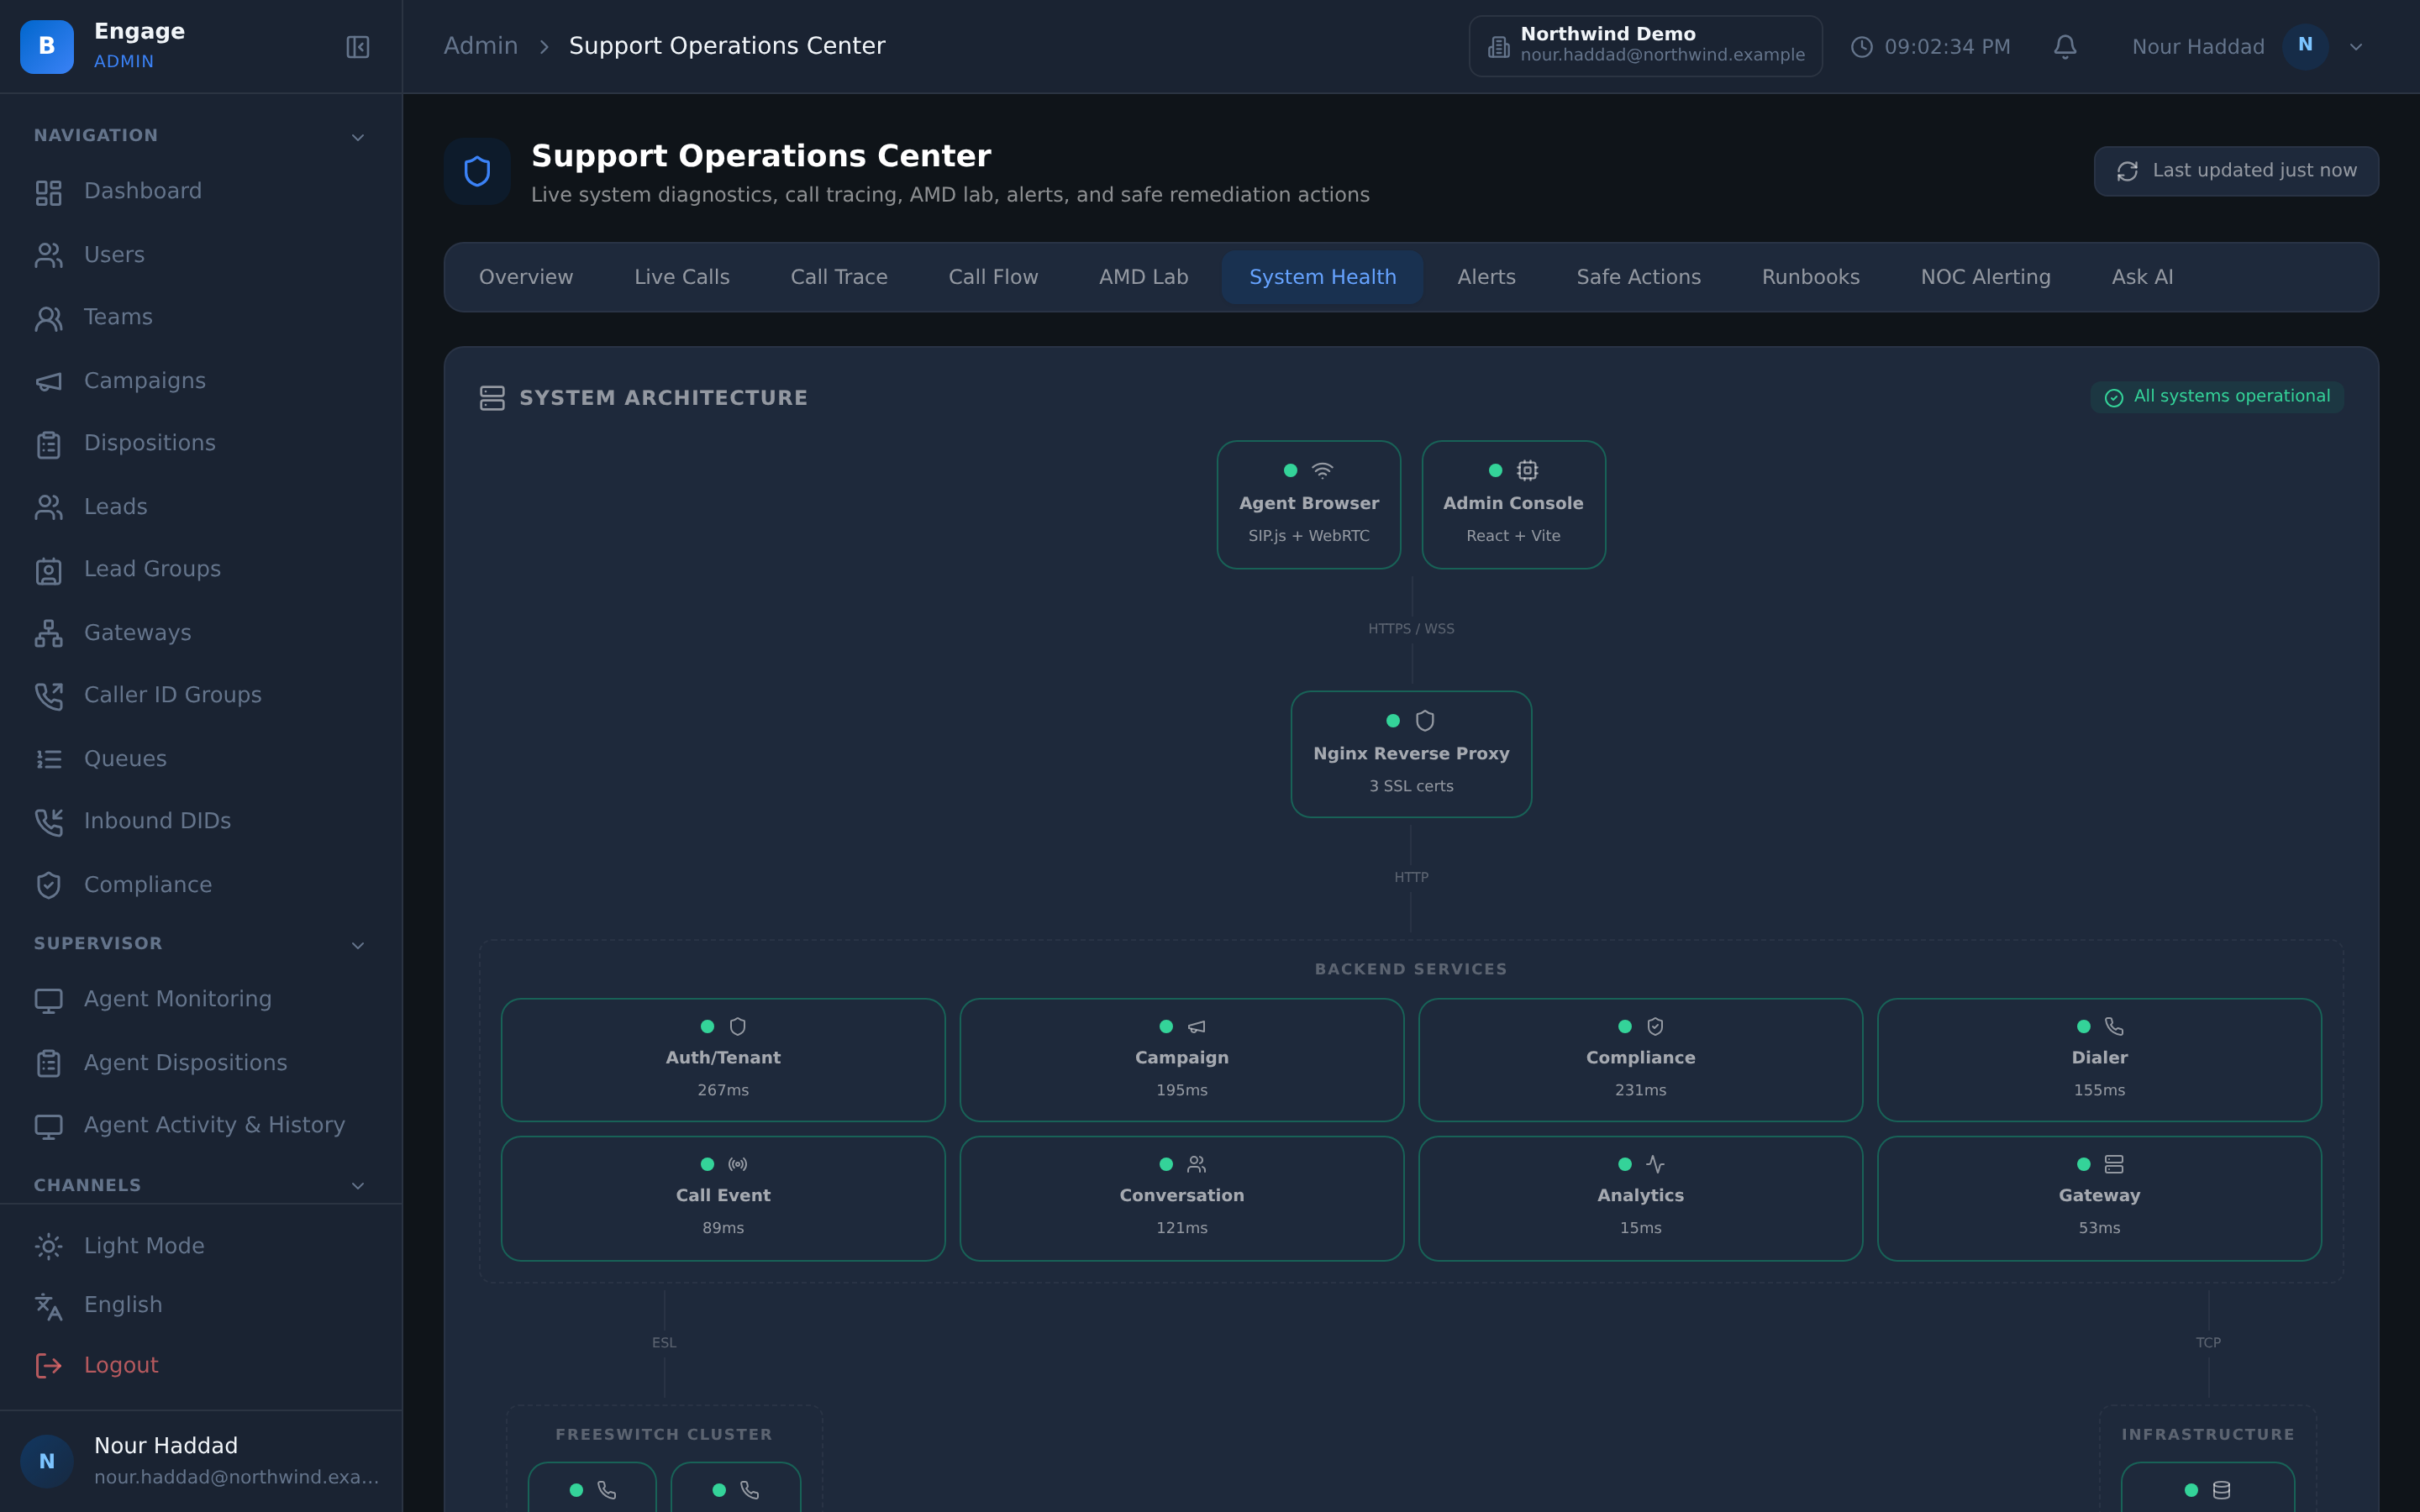
Due nodi media FreeSWITCH con failover degli agenti alla riconnessione, WebRTC con bilanciamento del carico, un bilanciatore di carico SIP che distribuisce le chiamate tra i nodi, readiness check che verificano le dipendenze reali, reconciler che rimettono in ordine dopo un'anomalia e backup notturni off-site.
Prova gratuita di 14 giorni · credito IA gratuito per provare l'agente vocale IA · senza carta di credito
Risposta rapida
Cosa ottieni
Tutto in un unico workspace
Due nodi media FreeSWITCH
Il traffico media gira su due nodi FreeSWITCH anziché su uno. Con un solo nodo, basta un pomeriggio storto perché diventi il tuo intero disservizio.
Failover WebSocket degli agenti
Il desktop dell'agente mantiene un WebSocket verso un nodo media. Se quel nodo non è più disponibile, il client dell'agente passa all'altro alla riconnessione.
WebRTC con bilanciamento del carico
L'audio degli agenti da browser è bilanciato tra i nodi, così gli agenti vengono distribuiti invece di accumularsi sul nodo che ha risposto per primo.
SIP in round-robin
Un bilanciatore di carico SIP distribuisce le chiamate in round-robin tra i nodi media, così il traffico degli operatori non dipende dalla disponibilità di un solo nodo.
Readiness basata sulle dipendenze
Gli endpoint di readiness verificano le dipendenze di cui un servizio ha davvero bisogno prima di dichiararlo pronto. Un servizio che non raggiunge il proprio database non deve ricevere traffico.
Reconciler delle chiamate orfane
Le chiamate che hanno perso il record che le controlla vengono riconciliate invece di restare attive. Una chiamata orfana genera costi, occupa un canale e non serve a nessuno.
Reconciler degli agenti bloccati
Un agente bloccato in uno stato da cui non riesce a uscire viene rilevato e riportato in uno stato reale, invece di passare il turno come un fantasma.
Reconciler delle chiamate in corso
Le chiamate in corso durante un riavvio o un'anomalia vengono poi riconciliate con la realtà, così la visione della piattaforma e quella dello switch coincidono.
Backup notturni del database
Il backup del database viene eseguito ogni notte. Non su richiesta, non quando qualcuno se ne ricorda: secondo una pianificazione.
Backup off-site
I backup sono conservati off-site, perché un backup che condivide la sorte di ciò che protegge non è un backup.
SLA di uptime sul piano Enterprise
Il piano Enterprise prevede uno SLA di uptime del 99,95%, scritto nel contratto e non lasciato intendere da una pagina di marketing.
Visibile dall'operations center
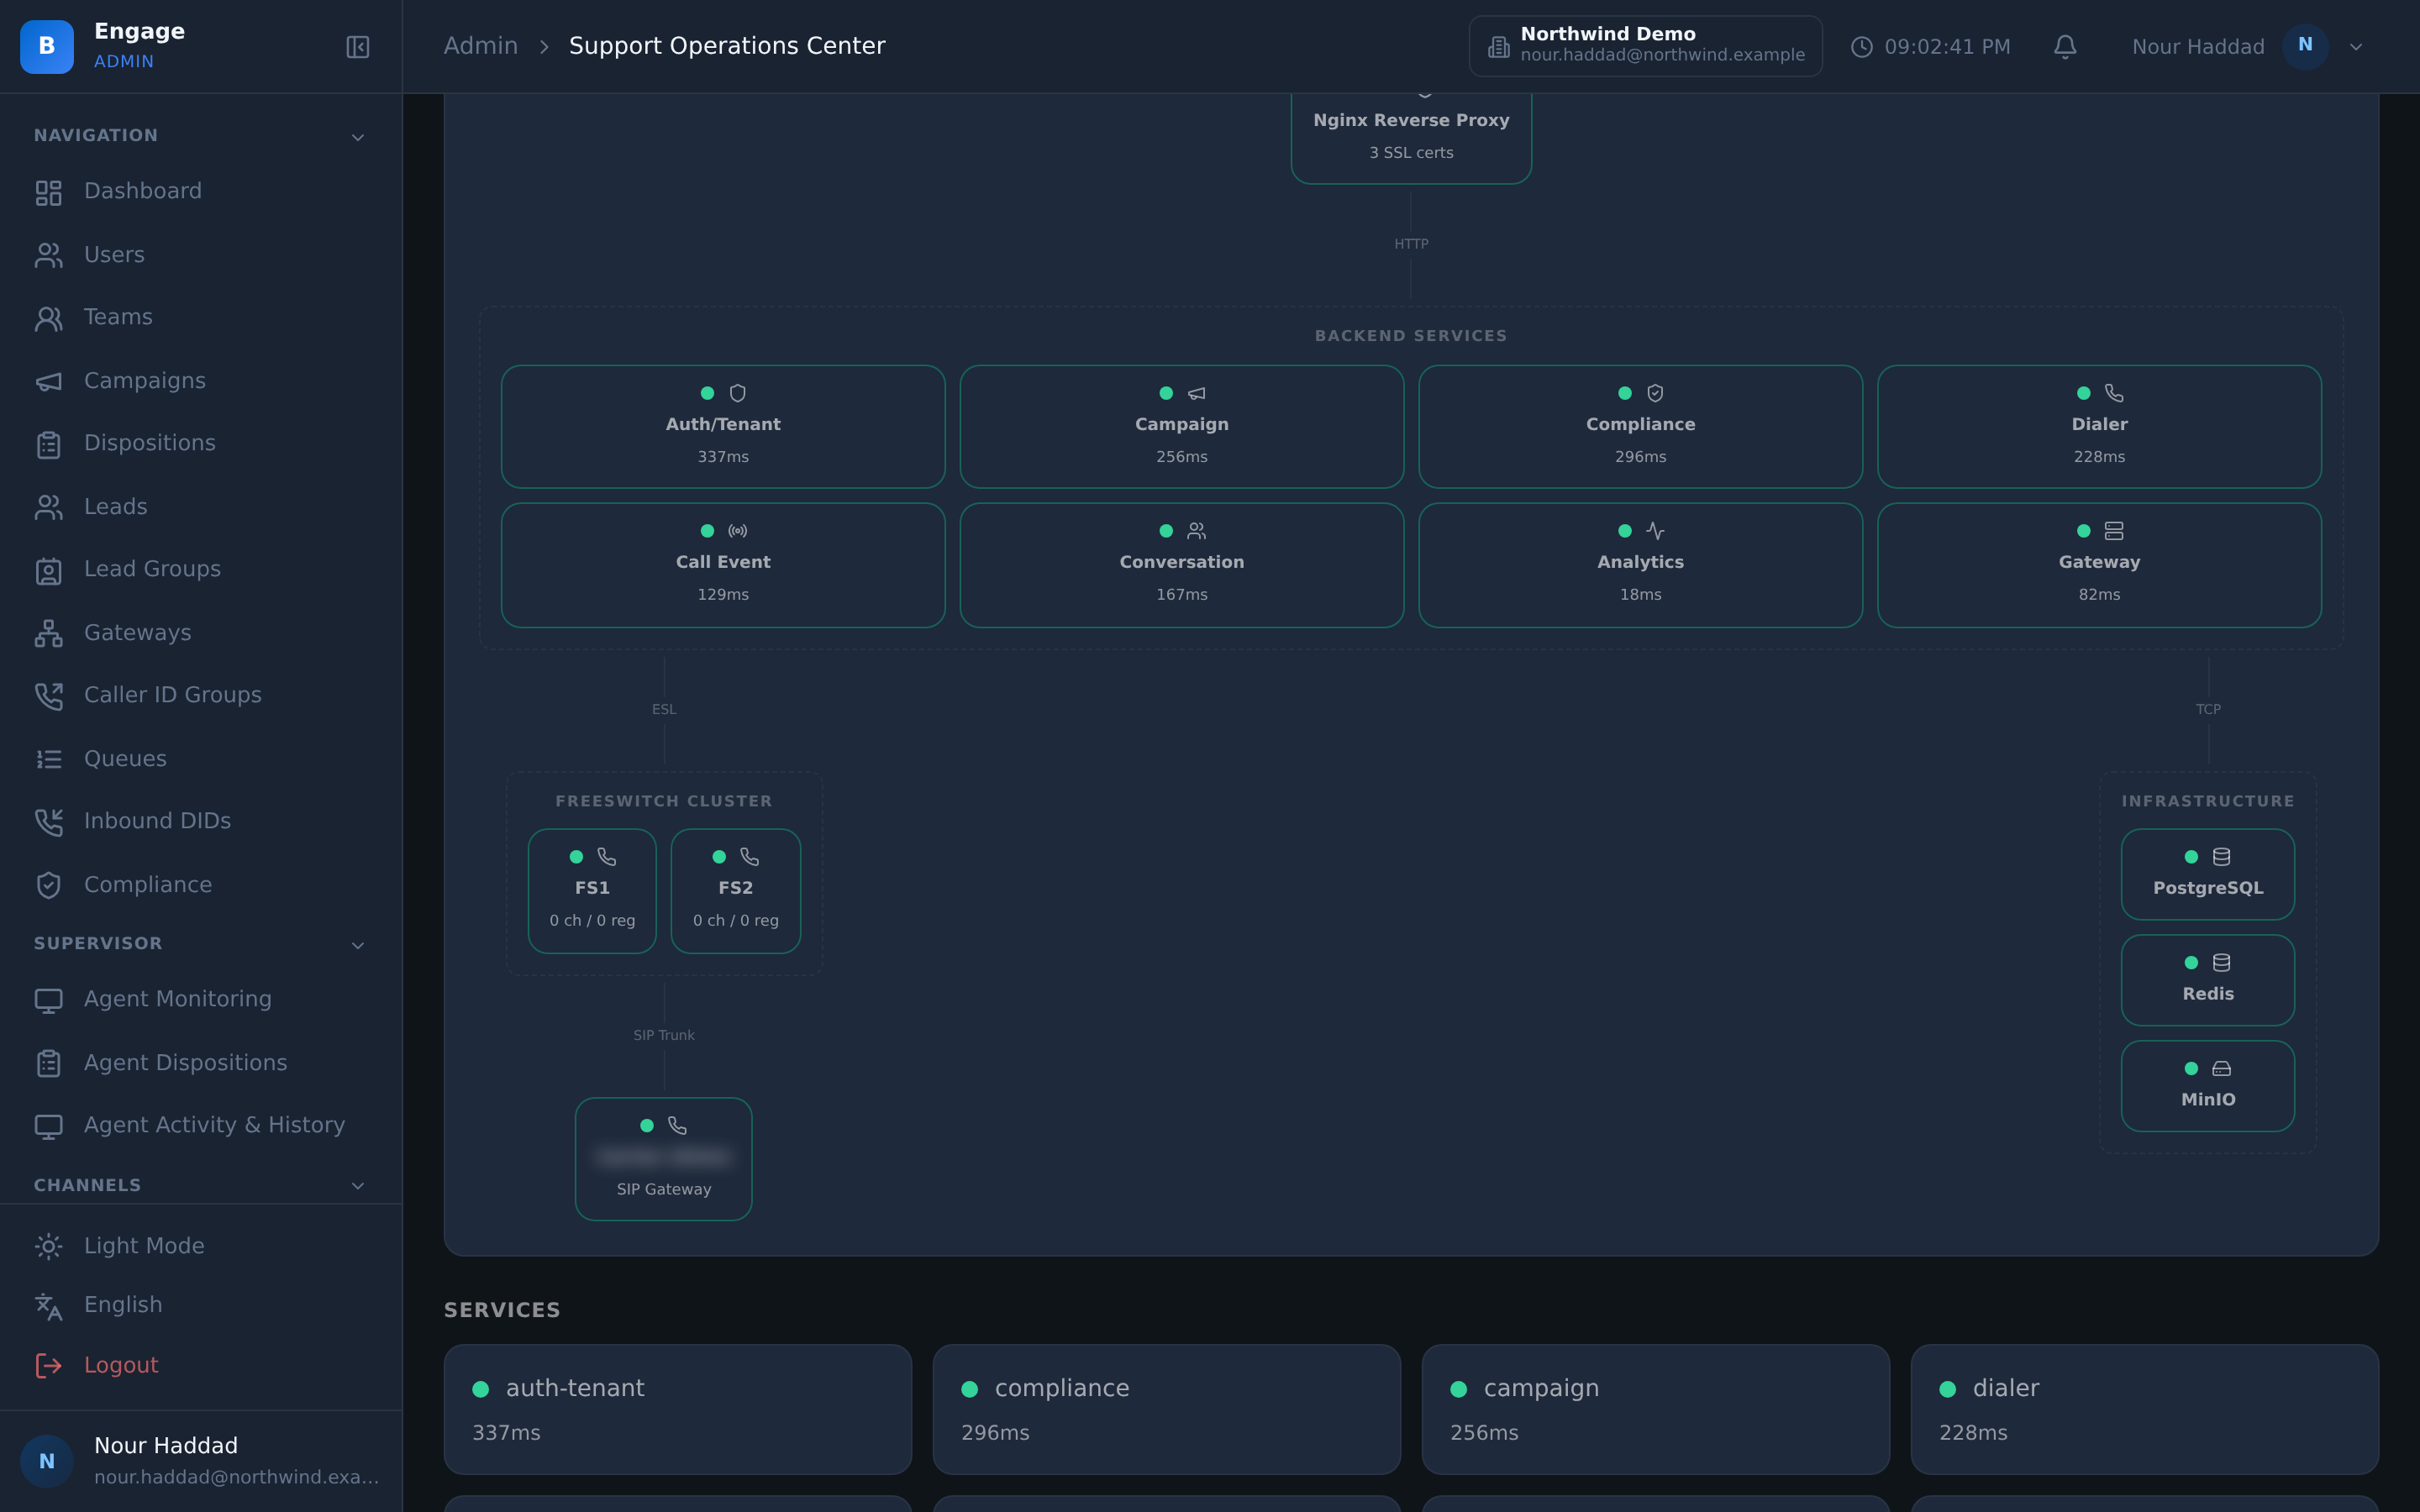
Stato dei nodi, chiamate live e attività dei reconciler sono visibili nell'operations center, così l'affidabilità è qualcosa che puoi osservare invece di darla per scontata.
Media
Due nodi, e un client che lo sa
Il traffico media gira su due nodi FreeSWITCH. Già questo è abbastanza comune. Ciò che decide se un agente si accorge di un disservizio è come reagisce il browser dell'agente.
Il desktop dell'agente mantiene un WebSocket verso un nodo e, quando quel nodo cade, il client passa all'altro nodo alla riconnessione. WebRTC è bilanciato tra i nodi e un bilanciatore di carico SIP distribuisce il traffico dei carrier in round-robin tra di essi, così né gli agenti né i carrier sono vincolati a una sola macchina.
- Due nodi media FreeSWITCH che gestiscono il traffico media
- Failover WebSocket degli agenti tra i nodi alla riconnessione
- WebRTC con bilanciamento del carico per gli agenti da browser
- Bilanciatore di carico SIP che distribuisce le chiamate in round-robin tra i nodi
Autocorrezione
La piattaforma rimette in ordine da sola
Le piattaforme di contact center di solito non si guastano in modo eclatante. Si guastano lasciando qualcosa indietro: una chiamata ancora attiva senza nulla che la controlli, un agente bloccato in uno stato da cui non riesce a uscire, una chiamata in corso quando un servizio si è riavviato.
Per tutti e tre i casi esistono i reconciler. Confrontano ciò che la piattaforma crede con ciò che sta realmente accadendo e correggono la differenza. Accanto a loro, gli endpoint di readiness verificano le dipendenze reali di un servizio prima che si dichiari pronto, così a nessun servizio viene affidato traffico che non può gestire.
- Reconciler per le chiamate orfane
- Reconciler per gli agenti bloccati
- Reconciler per le chiamate in corso durante i riavvii
- Endpoint di readiness che verificano le dipendenze prima di dichiarare il servizio pronto
Backup e impegno
Ogni notte, off-site e per iscritto
Il backup del database viene eseguito ogni notte e i backup sono conservati off-site. Contano entrambe le cose. Un backup notturno che risiede sulla stessa infrastruttura della piattaforma è una copia, non un piano di ripristino.
In più, il piano Enterprise prevede uno SLA di uptime del 99,95%. È nel contratto, che è il posto giusto per un impegno di disponibilità, non su una slide.
- Backup notturni del database
- Backup conservati off-site
- SLA di uptime del 99,95% sul piano Enterprise
- Stato dei nodi, chiamate live e attività dei reconciler visibili nell'operations center
Come si confronta
| Un'installazione su un solo server | Affidabilità della piattaforma DialerBee | |
|---|---|---|
| Media | Un nodo | Due nodi media FreeSWITCH |
| Quando un nodo cade | Gli agenti ricaricano la pagina e sperano | Failover WebSocket degli agenti tra i nodi alla riconnessione |
| Traffico dei carrier | Puntato su un unico indirizzo | Bilanciatore di carico SIP, round-robin tra i nodi |
| Audio dell'agente | Il nodo che ha risposto per primo | WebRTC con bilanciamento del carico tra i nodi |
| Controlli di stato | Il processo è attivo? | Endpoint di readiness che verificano le dipendenze del servizio |
| Residui dopo un'anomalia | Qualcuno li trova più tardi | Reconciler per chiamate orfane, agenti bloccati e chiamate in corso |
| Backup | Quando qualcuno se ne ricorda | Backup notturni del database, conservati off-site |
| Impegno | Best effort | SLA di uptime del 99,95% sul piano Enterprise |
Domande frequenti
Che cos'è l'affidabilità della piattaforma in DialerBee?+
È il modo in cui la piattaforma resta operativa e si corregge quando qualcosa va storto. Il traffico media gira su due nodi media FreeSWITCH con failover WebSocket degli agenti tra i nodi alla riconnessione, WebRTC con bilanciamento del carico e un bilanciatore di carico SIP che distribuisce le chiamate in round-robin tra i nodi. Gli endpoint di readiness verificano le dipendenze, i reconciler ripuliscono chiamate orfane, agenti bloccati e chiamate in corso, e il backup del database viene eseguito ogni notte e conservato off-site.
Cosa succede ai miei agenti se un nodo media si guasta?+
Il desktop dell'agente mantiene un WebSocket verso un nodo media. Se quel nodo non è più disponibile, il client dell'agente passa all'altro nodo alla riconnessione, così l'agente rientra sul nodo attivo invece di attendere quello guasto.
Come viene distribuito il traffico di chiamate tra i nodi?+
Un bilanciatore di carico SIP distribuisce le chiamate in round-robin tra i nodi media e l'audio degli agenti da browser è bilanciato tramite WebRTC. Né i carrier né gli agenti sono vincolati a un singolo nodo.
A cosa servono i reconciler?+
Correggono lo stato che rimane indietro quando qualcosa va storto. Uno riconcilia le chiamate orfane, cioè chiamate ancora attive senza nulla che le controlli. Uno riconcilia gli agenti bloccati, cioè agenti rimasti in uno stato da cui non riescono a uscire. Uno riconcilia le chiamate che erano in corso durante un riavvio. Ciascuno confronta ciò che la piattaforma crede con ciò che sta realmente accadendo.
Che cosa significa readiness basata sulle dipendenze?+
Un endpoint di readiness verifica le dipendenze di cui un servizio ha davvero bisogno prima di dichiarare che è pronto. Un servizio che non raggiunge ciò da cui dipende non riceve traffico: è la differenza tra un health check e un health check utile.
Come vengono gestiti i backup?+
Il backup del database viene eseguito ogni notte e i backup sono conservati off-site. Off-site è la parte che conta, perché un backup archiviato accanto alla piattaforma subisce qualunque cosa accada alla piattaforma.
C'è uno SLA di uptime?+
Sì, uno SLA di uptime del 99,95% sul piano Enterprise. È scritto nel contratto, non in una pagina di marketing.
Posso verificare qualcosa di tutto questo da solo?+
Sì. L'operations center mostra stato dei nodi, chiamate live e attività dei reconciler, insieme ad avvisi che puoi configurare per un NOC. Un'affidabilità che puoi osservare è più utile di un'affidabilità che ti viene solo raccontata.
Chiedici come si comporta DialerBee quando un nodo cade
Una presentazione di 30 minuti su un tenant demo, in inglese o in arabo.