Dépôt de messages vocaux et packs vocaux
Logiciel de dépôt de messagerie vocale : dites-le une fois, laissez la plateforme le répéter
Des modèles de messages vocaux générés à partir d'un script par synthèse vocale (TTS), dans la voix de votre choix, synchronisés sur chaque nœud média et déposés en un clic quand l'AMD détecte un répondeur. Des packs de messages multilingues pour l'IVR, les files et les enquêtes, plus une musique d'attente en TTS sous contrôle budgétaire.
Essai gratuit de 14 jours · crédit IA gratuit pour essayer l'agent vocal IA · sans carte bancaire
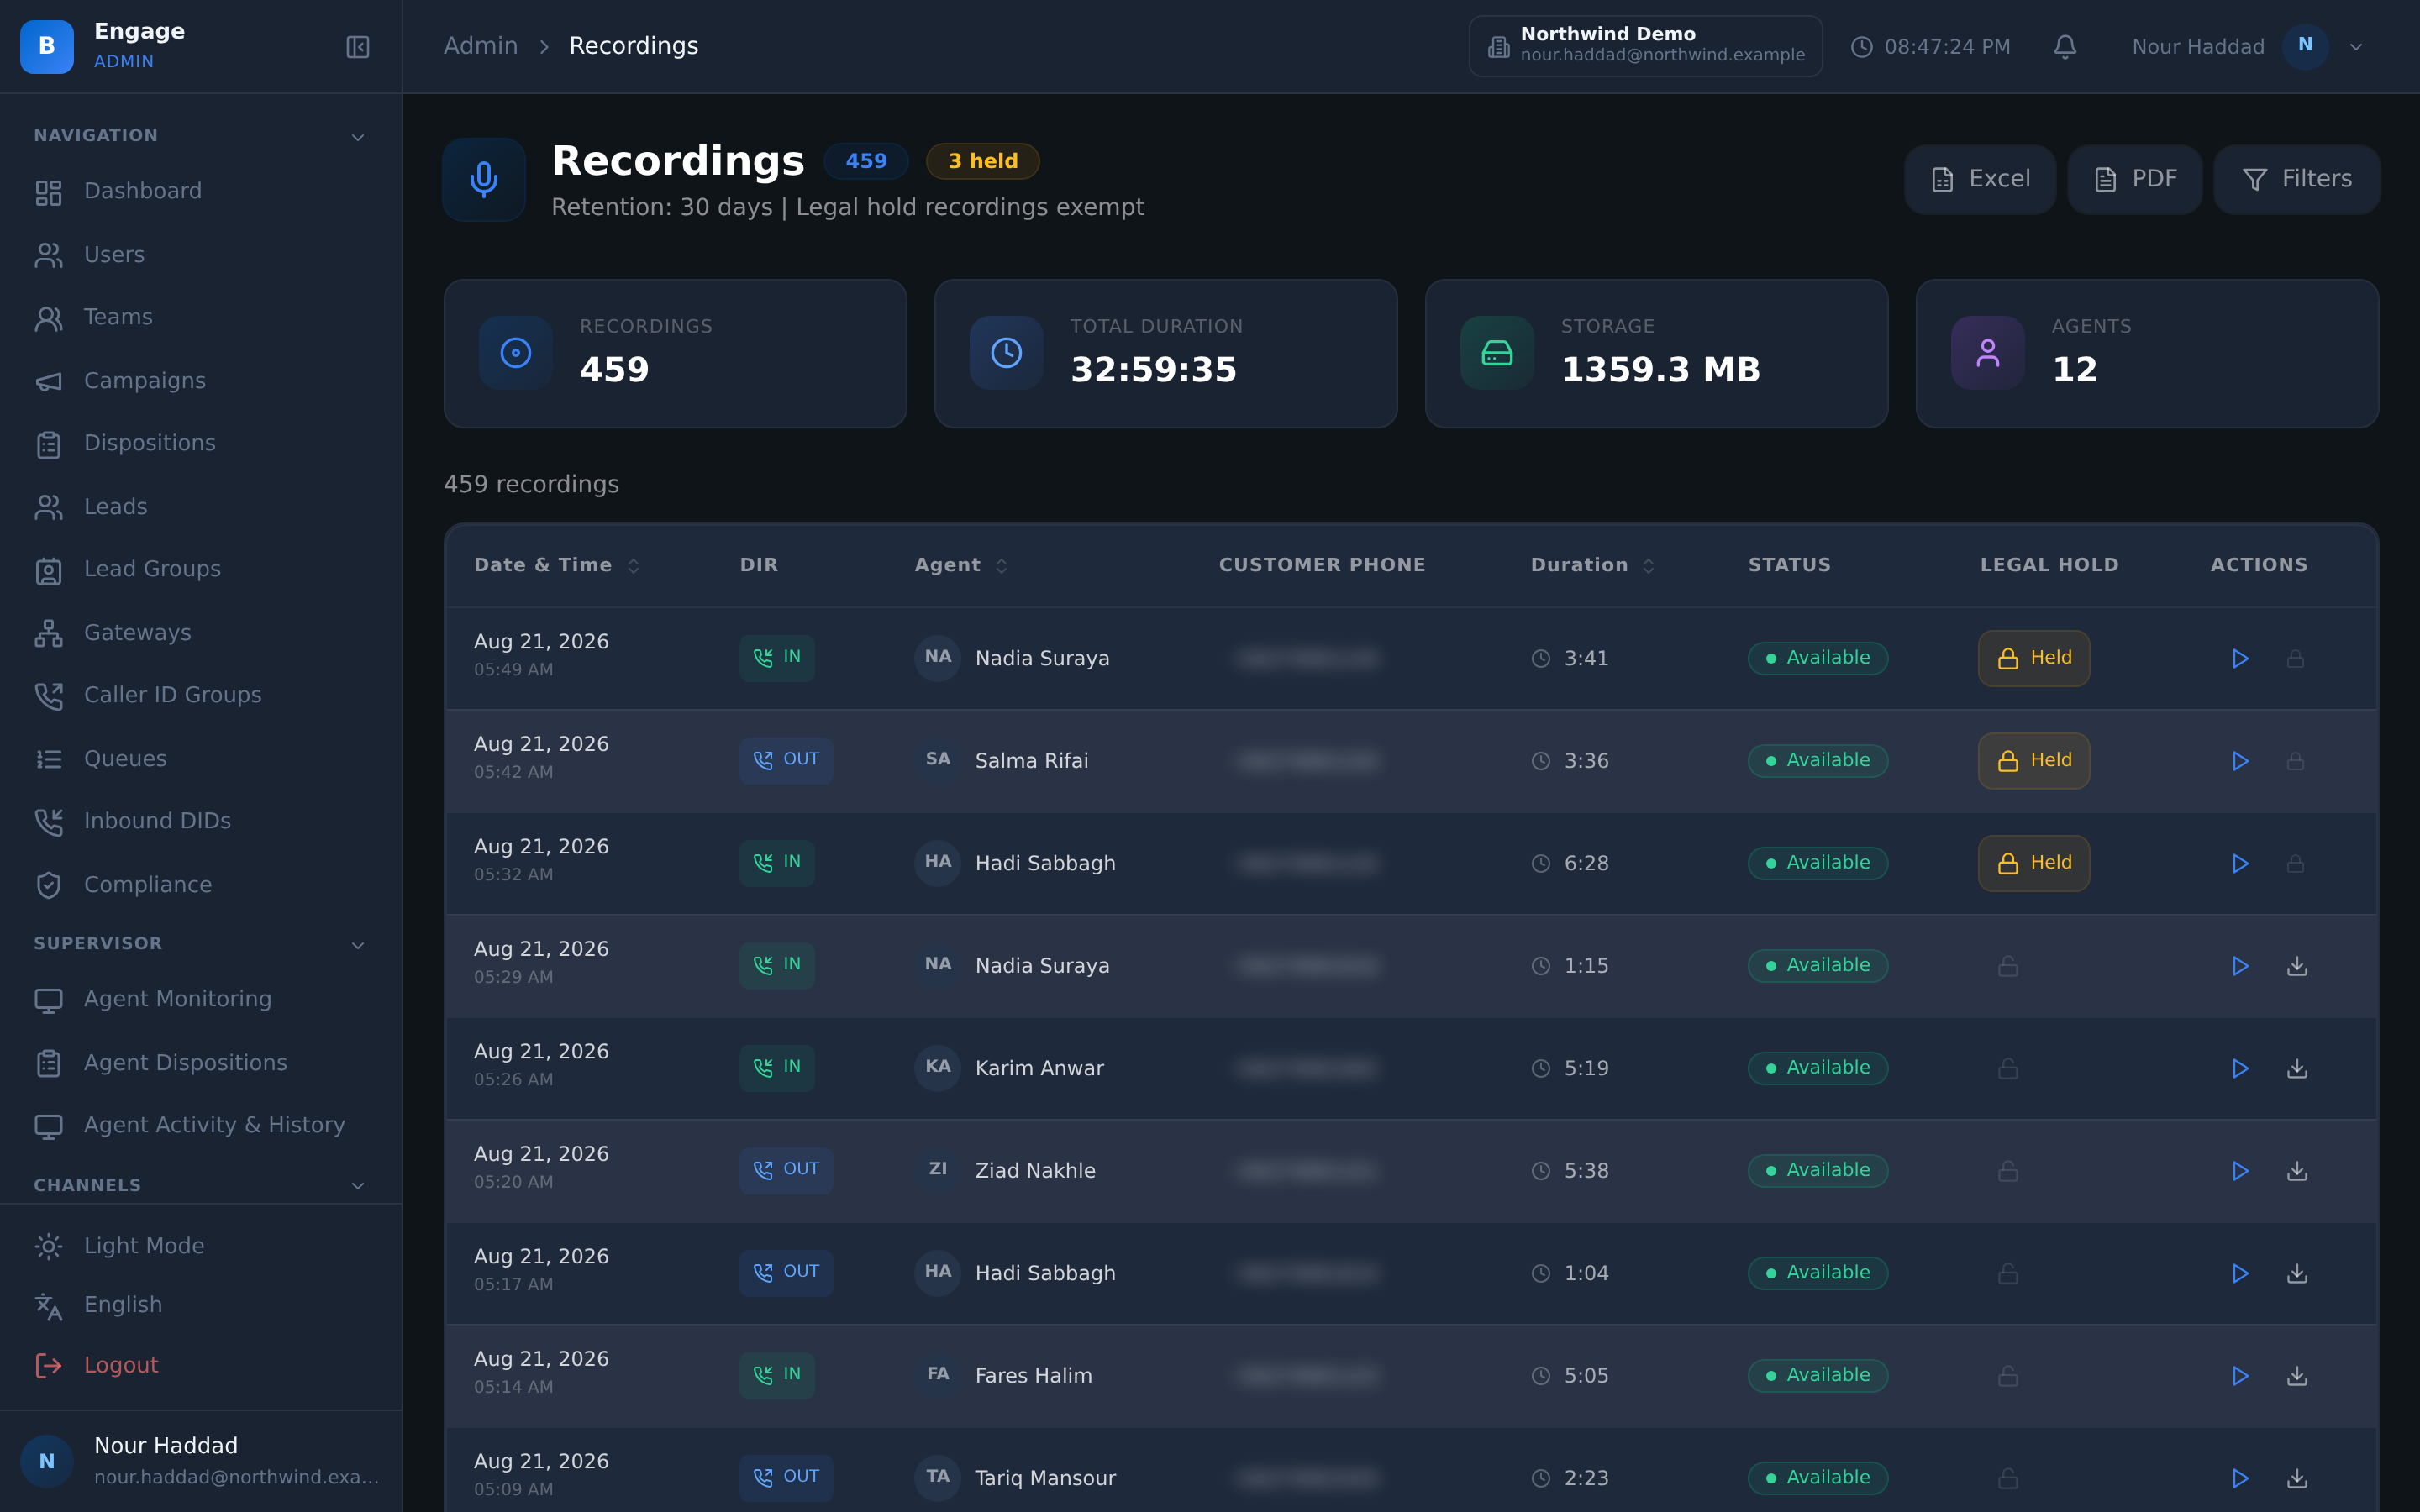
Réponse rapide
Ce que vous obtenez
Tout dans un seul espace de travail
Les modèles de dépôt de messagerie vocale
Gardez une bibliothèque de messages vocaux prêts à déposer, pour que l'agent n'improvise pas les mêmes trente secondes quarante fois par jour.
Générés par TTS
Rédigez le script, la plateforme génère l'audio. Pas de cabine, pas de séance d'enregistrement, pas d'attente du seul collègue qui a une belle voix.
Choisissez la voix
Choisissez la voix dans laquelle chaque modèle est généré, pour que le message corresponde à la marque et à la langue de diffusion.
Des scripts modifiables
Le script accompagne le modèle. Modifiez le texte, régénérez, et la nouvelle version sera déposée dès l'appel suivant.
Synchronisés sur chaque nœud média
Les modèles se synchronisent sur chaque nœud média : un dépôt fonctionne quel que soit le nœud où tourne l'appel. Un audio présent sur un seul nœud, c'est un bug qui attend un après-midi chargé.
Dépôt en un clic quand l'AMD détecte un répondeur
La détection de répondeur identifie la machine, l'agent dépose le message en un clic, puis passe à l'appel suivant pendant que le message est encore diffusé.
Packs vocaux multilingues
Des packs de messages en plusieurs langues : le parcours parle à l'appelant dans sa langue au lieu de l'obliger à s'adapter à la vôtre.
Utilisés par l'IVR, les files et les enquêtes
Un même pack vocal sert l'IVR, les files et les enquêtes : la même voix accompagne l'appelant tout au long de son parcours.
Importez vos propres messages
Si vous avez déjà des messages enregistrés par des professionnels, importez-les et utilisez-les à la place de l'audio généré.
Audio d'attente en TTS
Générez l'audio d'attente d'une file à partir d'un texte : le message qu'entend l'appelant peut être changé le jour même où vous décidez de le changer.
Contrôle budgétaire de la génération
La génération d'audio d'attente est soumise à un contrôle budgétaire : la commodité de générer de l'audio à la demande ne se transforme pas en facture que personne n'a surveillée.
Dans le même parcours d'appel
Dépôts, messages et audio d'attente se configurent dans la plateforme qui passe l'appel, pas dans un outil média séparé qu'il faut tenir synchronisé.
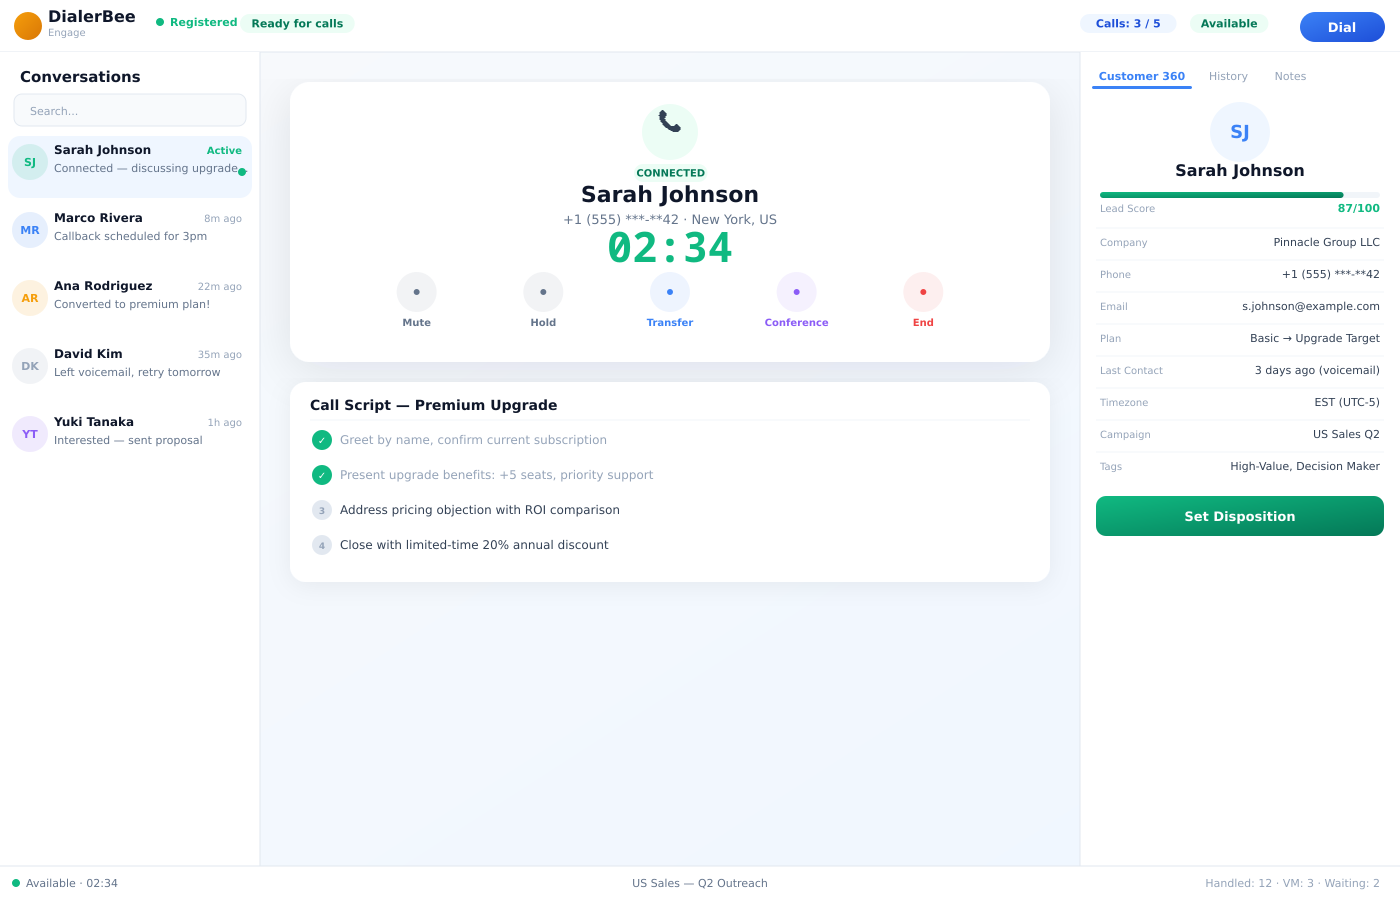
Dépôt de messagerie vocale
L'AMD détecte un répondeur, l'agent appuie une fois
Laisser un message vocal à la main coûte à un agent environ une demi-minute et un peu de moral, à chaque fois. Le dépôt de messagerie vocale supprime les deux.
La détection de répondeur identifie la machine, l'agent choisit un modèle et clique une fois, et le message est diffusé pendant qu'il passe à l'appel suivant. Les modèles sont générés à partir d'un script par TTS dans la voix de votre choix, et synchronisés sur chaque nœud média : le dépôt fonctionne quel que soit le nœud où tourne l'appel.
- Modèles générés par TTS à partir d'un script, dans la voix de votre choix
- Modifiez le script et régénérez ; la nouvelle version est déposée dès la fois suivante
- Synchronisés sur chaque nœud média : un dépôt ne dépend jamais d'un nœud
- Dépôt en un clic depuis le poste agent quand l'AMD détecte un répondeur
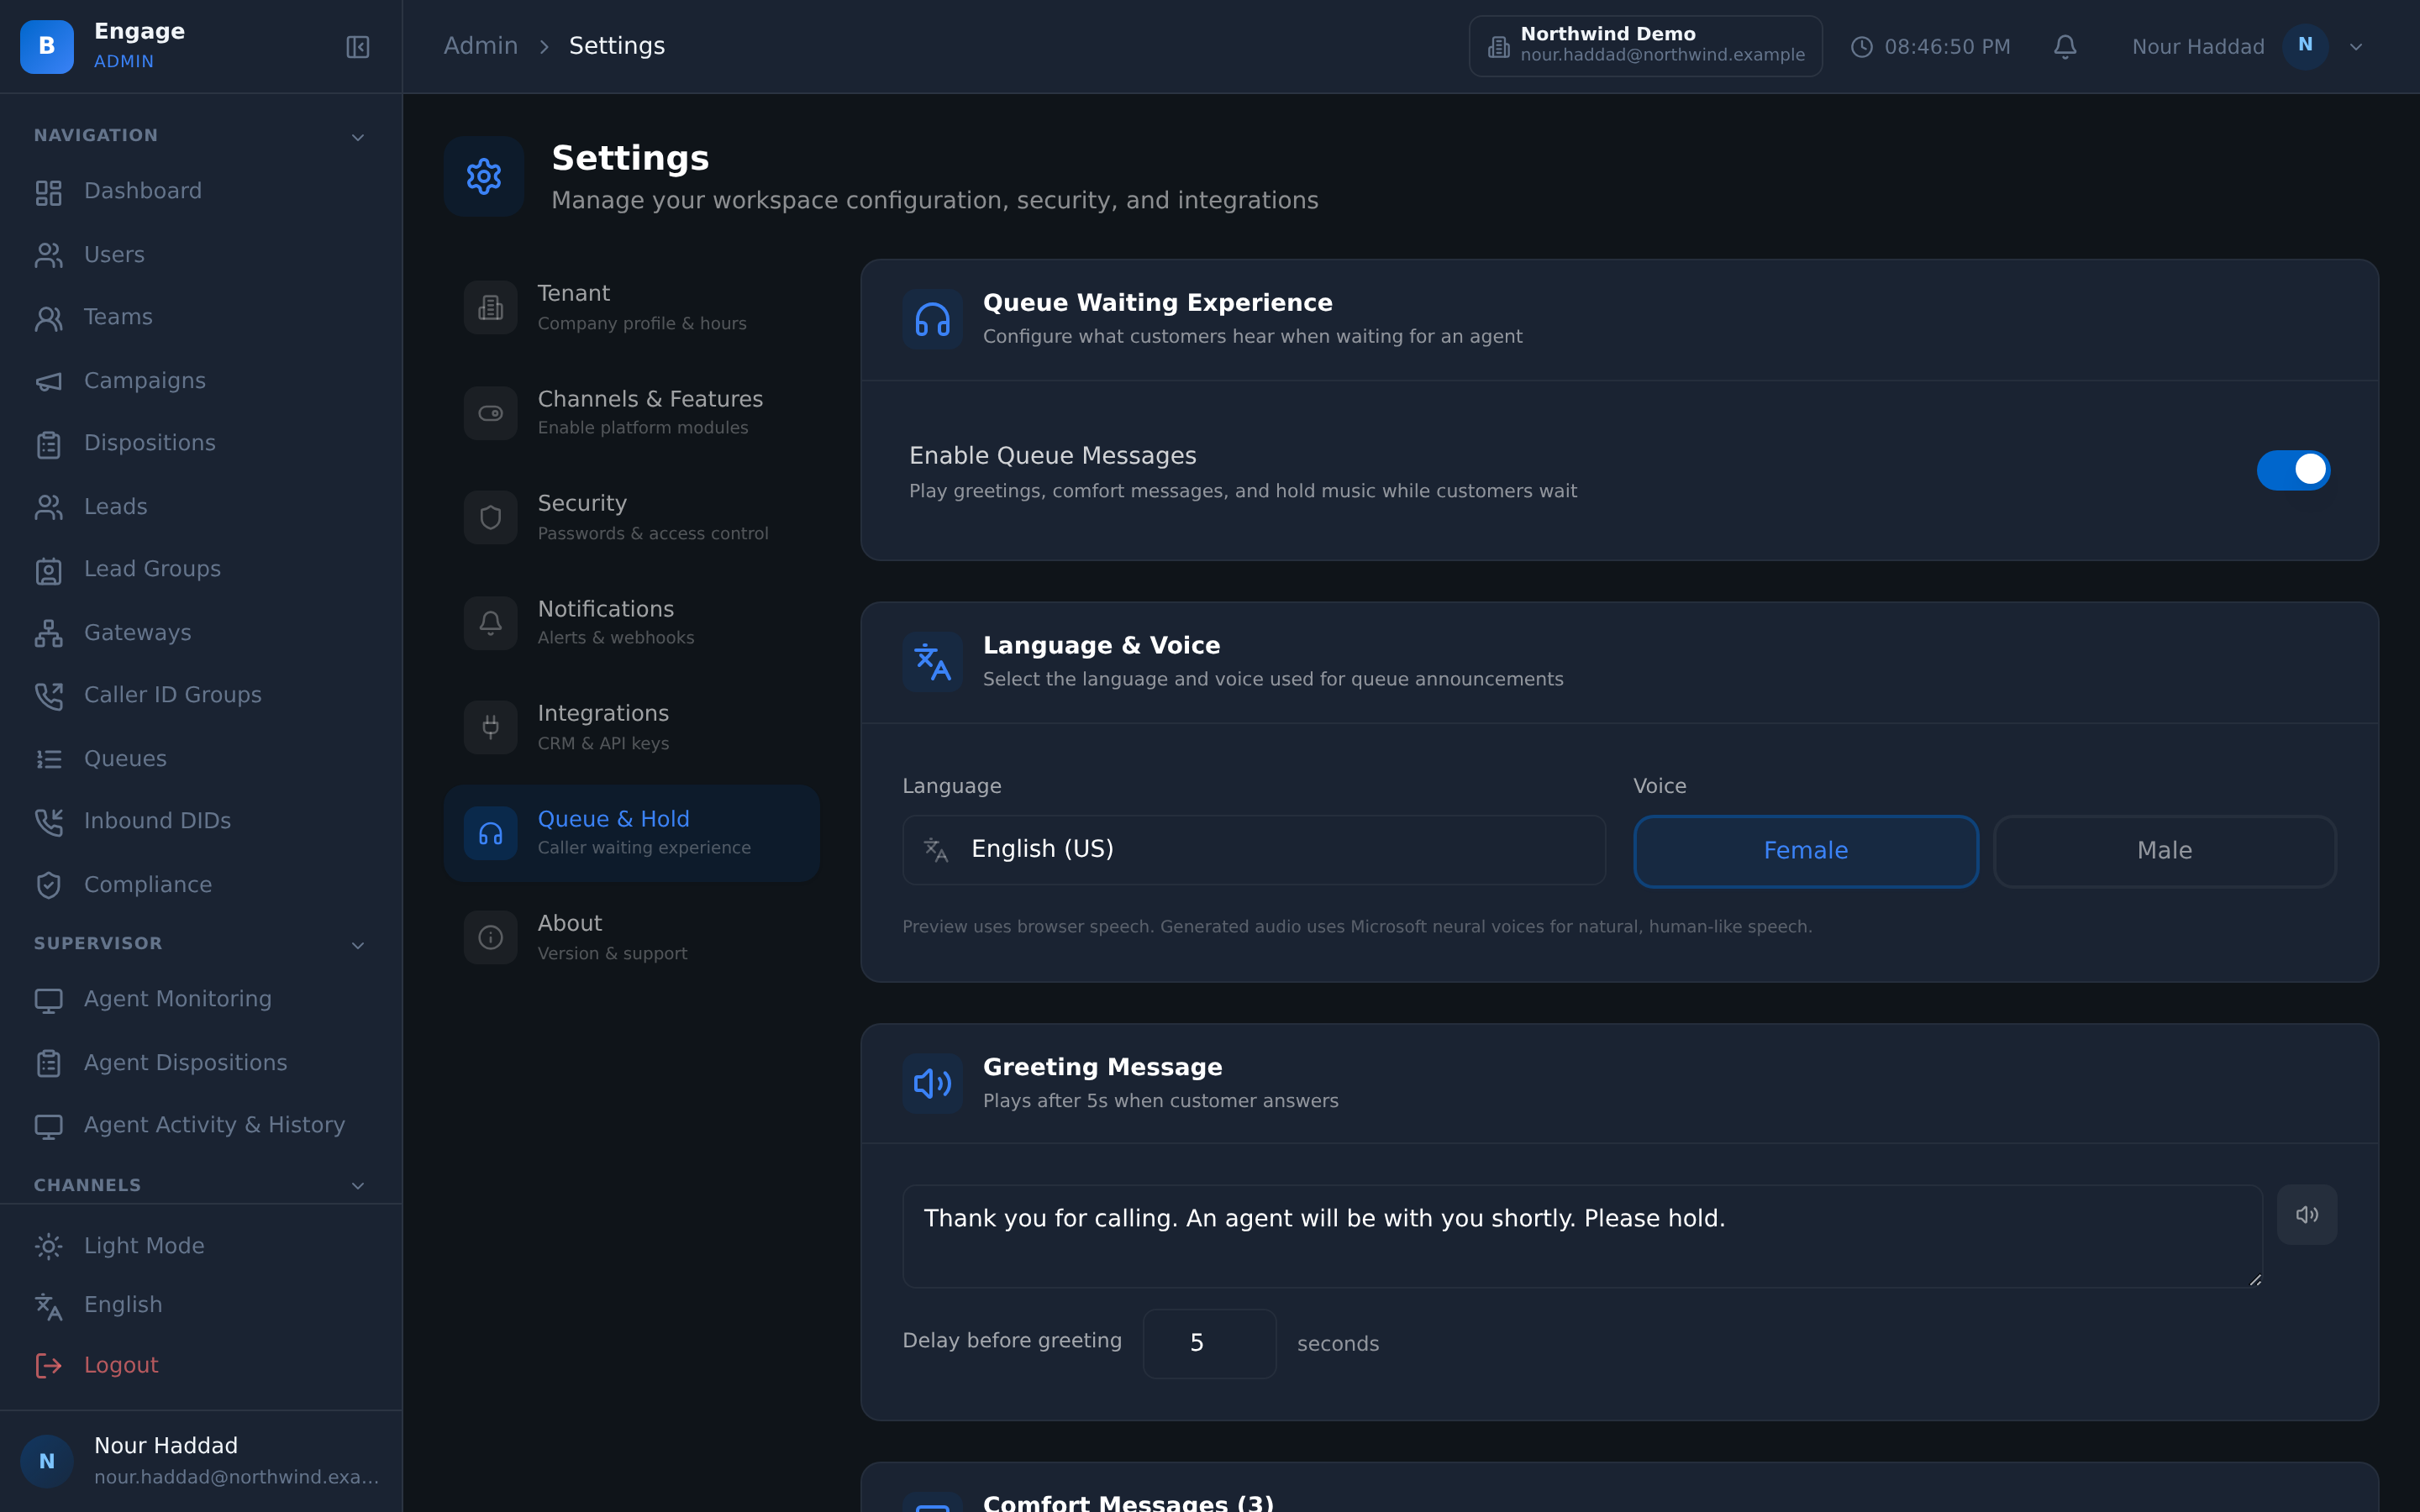
Les packs vocaux
Un seul pack, pour chaque parcours de l'appelant
Un pack vocal est un ensemble de messages dans une langue. L'IVR l'utilise, les files l'utilisent, les enquêtes l'utilisent : l'appelant entend une seule voix, de sa mise en relation jusqu'à sa réponse à la dernière question.
Les packs sont multilingues — tout l'intérêt sur un marché où le même numéro est servi en arabe et en anglais le même jour. Si vous avez déjà des messages enregistrés par des professionnels, importez-les : le pack les utilise à la place de l'audio généré.
- Packs de messages multilingues
- Utilisés par l'IVR, les files et les enquêtes
- Importez vos propres messages enregistrés à la place des messages générés
- Le même pack accompagne l'appelant tout au long du parcours
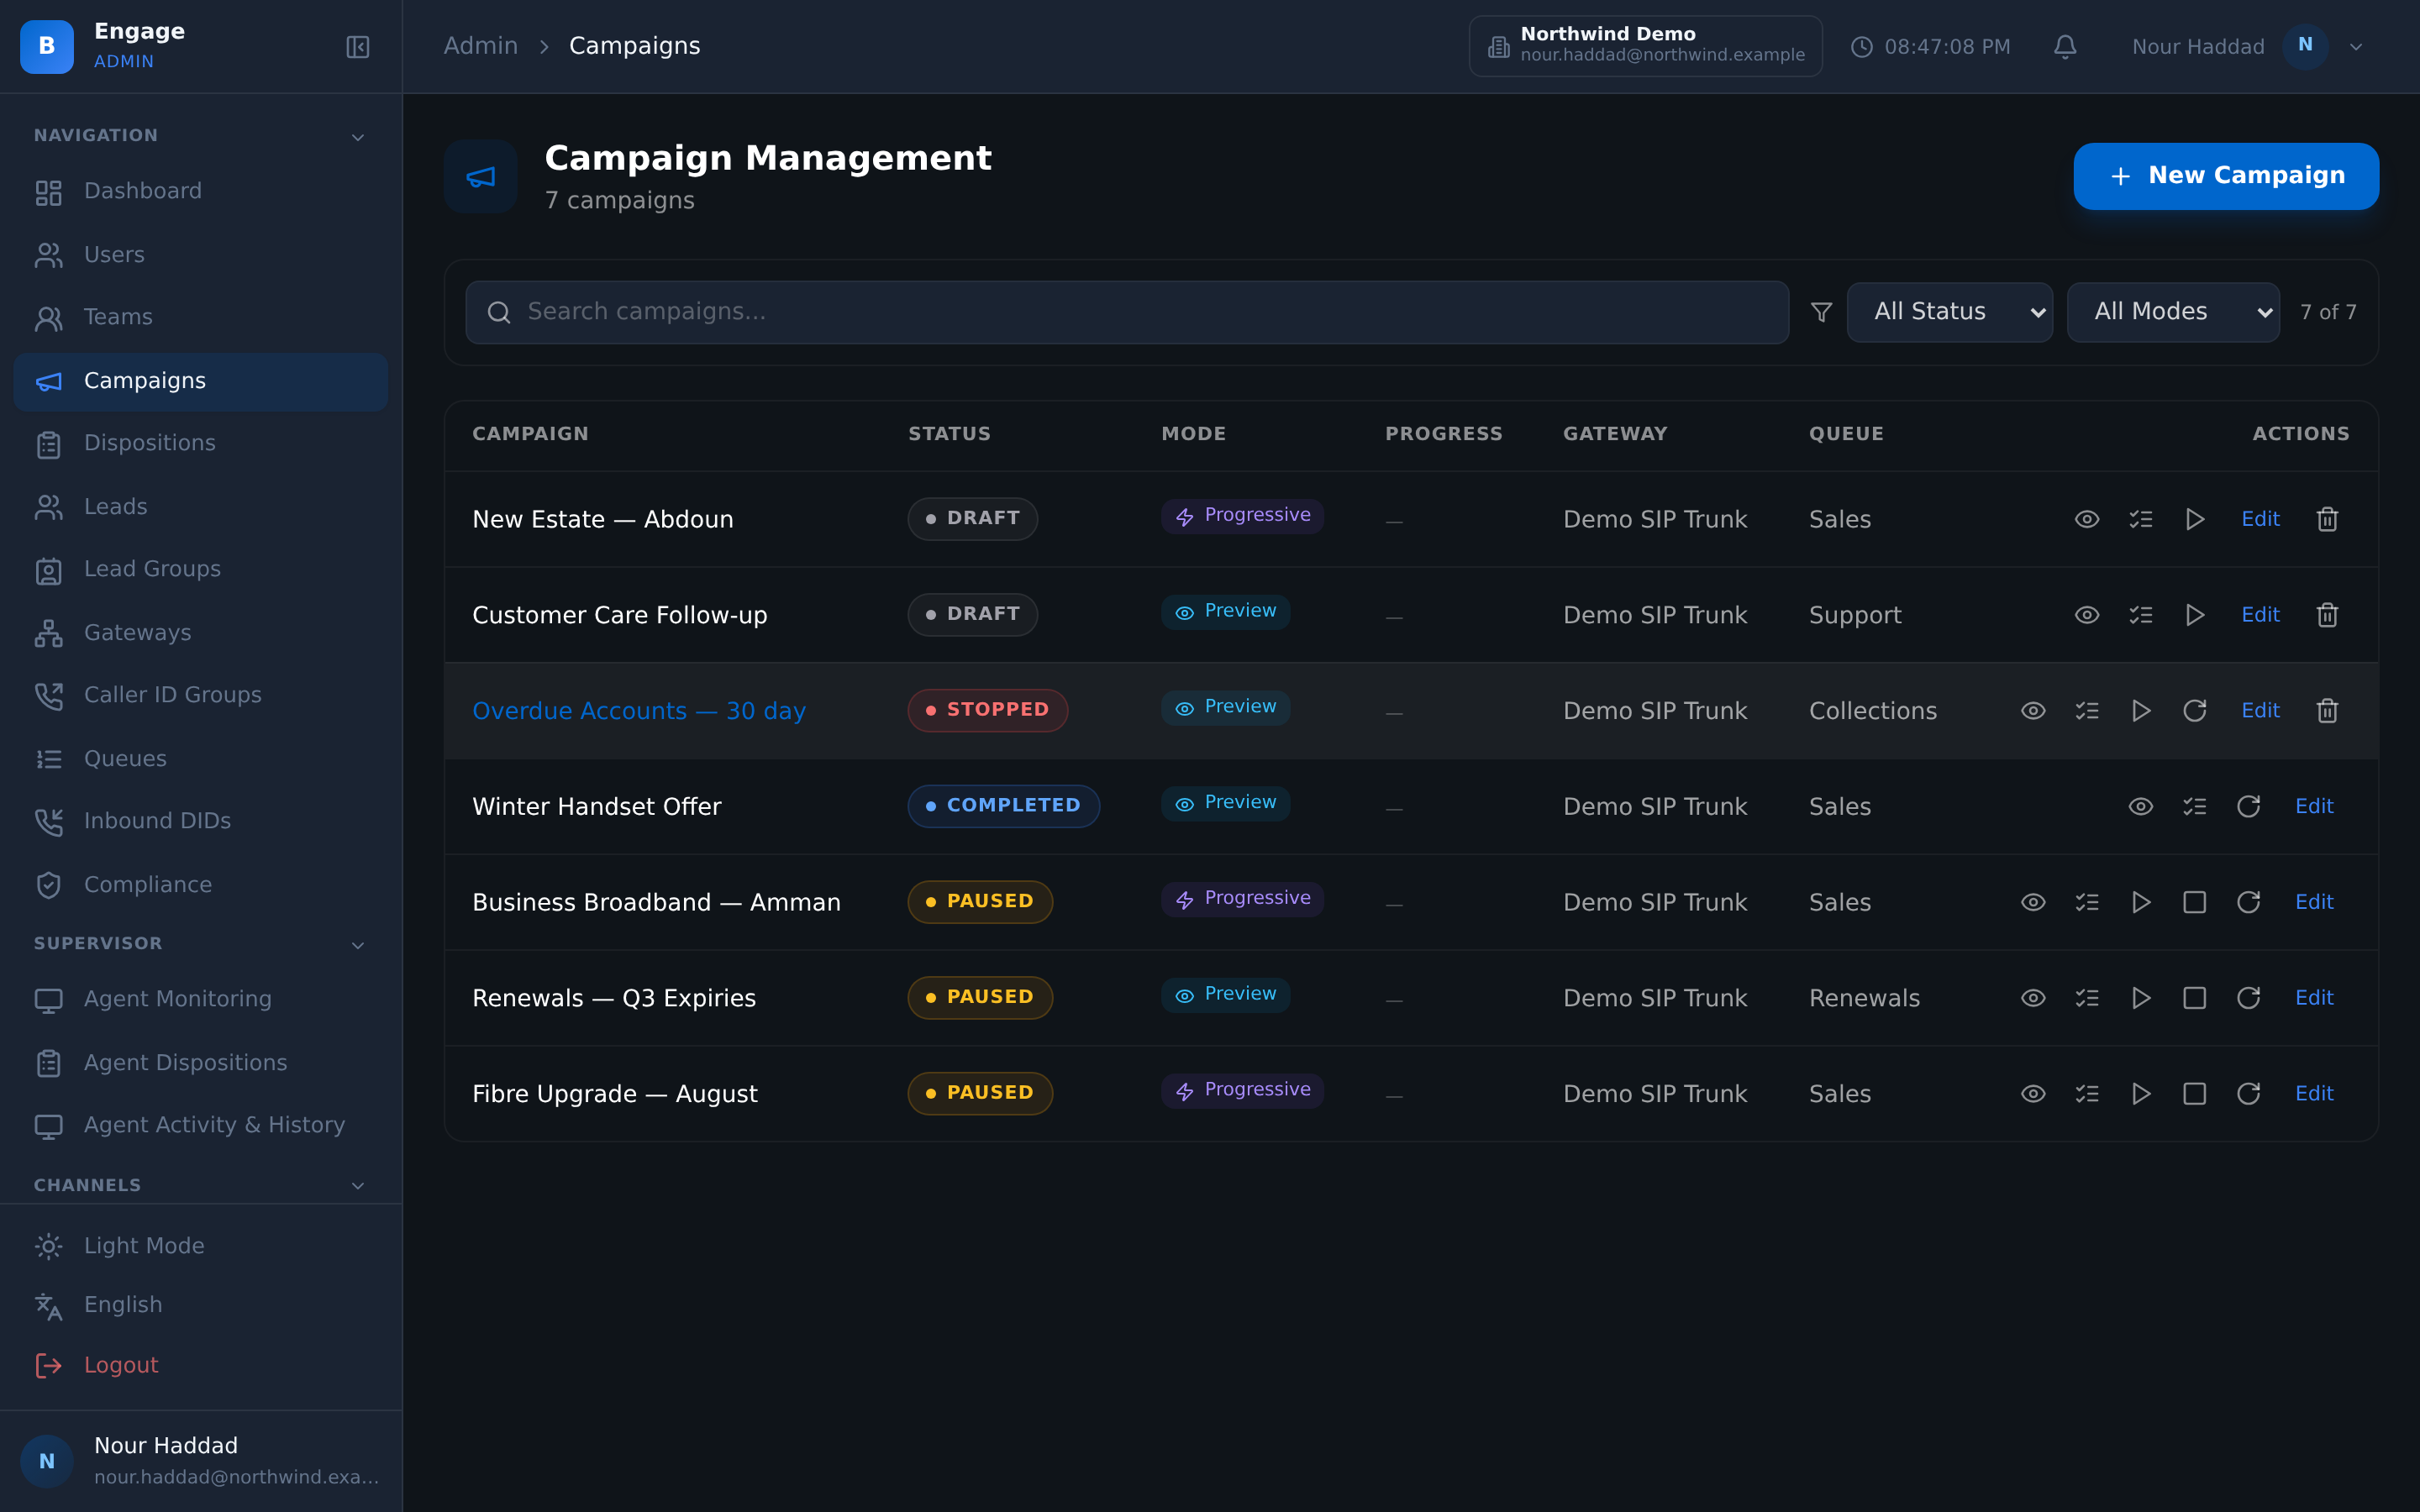
Audio d'attente
Changez le son de l'attente, dès aujourd'hui
L'audio d'attente des files est généré par TTS : le message qu'entend l'appelant est un texte modifiable, pas un fichier que quelqu'un doit réenregistrer et vous renvoyer.
La génération est soumise à un contrôle budgétaire. Il existe parce que la génération audio à la demande est exactement le genre de commodité qui fait grimper la facture en silence, et un plafond vaut mieux qu'une surprise mensuelle.
- Audio d'attente des files généré par TTS à partir de texte
- Contrôle budgétaire de la génération
- Les mêmes voix que pour les modèles et les packs vocaux
- Configuré dans la plateforme qui gère la file
Comment il se compare
| Enregistrement audio manuel | Dépôt de messagerie vocale et packs vocaux DialerBee | |
|---|---|---|
| Produire l'audio | Réserver quelqu'un, enregistrer, monter, importer | Rédiger un script, choisir une voix, générer |
| Modifier la formulation | Recommencer tout le processus | Modifier le script et régénérer |
| Laisser un message vocal | L'agent le récite, appel après appel | L'AMD détecte le répondeur, l'agent dépose le message en un clic |
| Où se trouve l'audio | Importé à un seul endroit, en espérant qu'il soit copié | Synchronisés sur chaque nœud média |
| Les messages d'un parcours à l'autre | Des fichiers différents pour l'IVR, les files et les enquêtes | Un seul pack vocal pour l'IVR, les files et les enquêtes |
| Musique et messages d'attente | Un fichier que vous ne pouvez pas modifier rapidement | Audio d'attente TTS modifiable comme du texte, sous contrôle budgétaire |
Questions fréquentes
Qu'est-ce que le dépôt de messagerie vocale dans DialerBee ?+
C'est une bibliothèque de modèles de messages vocaux que l'agent peut déposer en un clic. Chaque modèle est généré par synthèse vocale à partir d'un script, dans la voix de votre choix, et les modèles sont synchronisés sur chaque nœud média. Quand la détection de répondeur identifie une machine, l'agent dépose le message et passe à la suite pendant sa diffusion.
Comment crée-t-on un modèle de message vocal ?+
Vous rédigez le script, choisissez la voix, et la plateforme génère l'audio. Aucune séance d'enregistrement. Si vous changez le texte plus tard, vous modifiez le script et régénérez : c'est la nouvelle version qui sera déposée ensuite.
Est-ce à l'agent de déterminer qu'il s'agit d'un répondeur ?+
C'est le rôle de la détection de répondeur. Quand l'AMD détecte une machine, le dépôt se fait en un clic depuis le poste agent : l'agent n'écoute pas une annonce pour savoir s'il doit parler.
Pourquoi est-il important que les modèles soient synchronisés sur chaque nœud média ?+
Parce que les appels ne tournent pas tous sur le même nœud. Si un modèle n'existe que sur un nœud, les dépôts échouent sur les autres — en général le jour le plus chargé. Les modèles sont synchronisés sur chaque nœud média pour que le comportement soit identique, où que l'appel arrive.
Qu'est-ce qu'un pack vocal ?+
Un ensemble de messages dans une langue, utilisé par l'IVR, les files et les enquêtes. Les packs sont multilingues : un parcours peut s'adresser à l'appelant dans sa propre langue au lieu d'une langue par défaut.
Puis-je utiliser mes propres messages enregistrés ?+
Oui. Importez vos propres messages dans un pack vocal : ils remplacent l'audio généré. Les messages générés sont là pour que vous ne soyez pas bloqué en attendant un studio, pas pour vous empêcher d'en utiliser un.
Comment fonctionne l'audio d'attente des files ?+
Il est généré par synthèse vocale : ce qu'entend l'appelant en attente est un texte modifiable, pas un fichier à commander. La génération est soumise à un contrôle budgétaire pour que l'audio à la demande ne devienne pas un coût non surveillé.
Le dépôt de messagerie vocale et les packs vocaux fonctionnent-ils en arabe ?+
Oui. Les packs vocaux contiennent des messages par langue : les messages en arabe peuvent être générés par synthèse vocale dans une voix choisie ou importés à partir de vos propres enregistrements, et le même pack sert l'IVR, les files et les enquêtes.
Écoutez un dépôt et un pack vocal sur un tenant de démo
Une présentation de 30 minutes sur un tenant de démo, en anglais ou en arabe.